
Chaque phrase que vous validez est stockée, classée et proposée à nouveau la prochaine fois qu’elle apparaît dans ce fichier, dans la mise à jour du mois prochain, dans le projet d’un autre client. Les coûts de retraduction diminuent jusqu’à 60 %.
Chaque phrase que vous validez est stockée, classée et proposée à nouveau la prochaine fois qu’elle apparaît dans ce fichier, dans la mise à jour du mois prochain, dans le projet d’un autre client. Les coûts de retraduction diminuent jusqu’à 60 %.
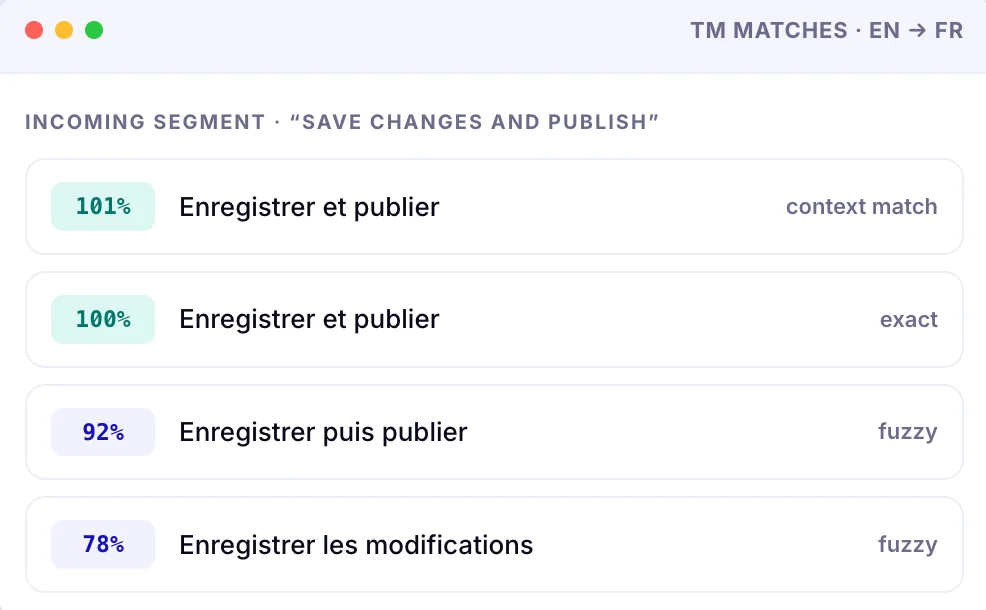
Les correspondances classées apparaissent dès que vous entrez dans un segment, avec une insertion en un clic et les différences mises en évidence.
Validez un segment une fois et chaque segment identique du fichier se met automatiquement à jour avec celui-ci.
La mémoire est partagée entre les projets et les clients, de sorte que la cohérence et les économies s’accumulent au fil du temps au lieu d’être réinitialisées à chaque mission.
Une MT neuronale qui capture le ton et la terminologie, pas seulement des paires de chaînes — pour que les suggestions se lisent comme si vous les aviez écrites vous-même.
La terminologie approuvée est appliquée conjointement avec la mémoire, et les écarts sont signalés dans le contexte.
Certifié SOC 2 Type II, conforme au RGPD, résidence des données dans l’UE par défaut. Votre contenu n’entraîne jamais de modèles publics.
| Ce qui compte | Tableur & recherche | TMS hérité | WordBeam |
|---|---|---|---|
| Retrouver une traduction passée | Ctrl+F dans les anciens fichiers | Recherche dans l’outil | Correspondances classées dès que vous entrez dans le segment |
| Correspondances floues (similaires, pas identiques) | Aucune | Oui | Oui, avec les différences mises en évidence |
| Propagation automatique des répétitions | Copier-coller manuel | Généralement | Confirmez une fois, appliqué à tout le fichier |
| Réutilisation entre clients et projets | Ce dont vous vous souvenez | Par projet, souvent par niveau | Partagée entre tous les projets |
| Apprend votre ton et votre terminologie | — | Base de données statique | MT neuronale, s’adapte à votre voix |
| Contrôle de la terminologie | Un deuxième tableur | Module complémentaire | Base terminologique incluse |
| Contrôles qualité par rapport à la mémoire | — | Rapport groupé à la fin | En direct, à chaque frappe |
| Qui possède les données | Vous | Souvent la plateforme ou le client | Vous, jamais utilisé pour entraîner des modèles publics |
| Modèle de coût | Gratuit, payé en heures de travail | Par poste, contrat annuel | À partir de 30 $/mois, paiement au mot |
Un logiciel de mémoire de traduction enregistre chaque phrase que vous traduisez sous forme de paire source-cible, puis propose automatiquement cette traduction dès qu’une phrase identique ou similaire réapparaît.
Ce n’est pas de la traduction automatique. Rien n’est généré : les suggestions proviennent de votre propre travail préalablement validé, classé en fonction du degré de correspondance entre la nouvelle phrase et celle enregistrée. Vous restez l’auteur, le logiciel vous évite simplement de vous retaper.
Les bénéfices s’accumulent. Le premier projet alimente la mémoire ; chacun des projets suivants arrive partiellement traduit, et la cohérence sur des années de travail avec le même client devient automatique plutôt qu’un exploit de mémoire.
| Correspondance | Ce que cela signifie | Ce que vous en faites |
|---|---|---|
| 101% Correspondance de contexte | Phrase identique et segments environnants identiques, même place, même structure de document. | Accepter. La correspondance la plus sûre qui soit. |
| 100% Correspondance exacte | Phrase identique, contexte différent. En général correcte, nécessite parfois une vérification du genre, du nombre ou du registre. | Parcourir rapidement et confirmer. |
| 75–99% Correspondance floue | Phrase similaire avec des mots ajoutés, supprimés ou modifiés. La différence est mise en évidence pour vous. | Modifier le delta, pas toute la phrase. |
| <75% Aucune correspondance exploitable | Nouveau contenu. Pré-traduit par le moteur d’IA de votre choix si vous voulez un premier jet. | Traduire, puis il rejoint la mémoire. |
| Type de segment | Mots | Part | Effort | Charge de travail effective |
|---|---|---|---|---|
| Correspondances 101 % / 100 % | 9,000 | 18% | Confirmées automatiquement | 0 mot |
| Floues 75–99% | 11,000 | 22% | Modifier la différence mise en évidence | ~4,400 mots |
| Nouveau contenu | 30,000 | 60% | Traduction complète (premier jet IA en option) | 30,000 mots |
| Total | 50,000 | 100% | — | ~34,400 mots · 31 % de travail en moins |
Exemple illustratif. Les segments flous sont comptés ici à environ 40 % d’un effort complet ; votre répartition réelle dépend du client et du type de contenu. WordBeam affiche l’analyse réelle par fichier avant que vous n’acceptiez la mission.
Votre mémoire est votre atout, pas celui du fournisseur. Importez le travail que vous avez déjà réalisé et continuez à le développer.
Téléversez les fichiers bilingues que vous possédez déjà — SDLXLIFF, MQXLIFF, MXLIFF, XLIFF ou DOCX bilingue — et reprenez la traduction là où vous l'avez laissée.
CSV, DOCX, XLSX, IDML, JSON, PO, PPTX, SCC, SRT, TSV et TXT sont pris en charge nativement, donc rien ne change pour le client.
Aucun contrat annuel et aucun frais par utilisateur. Facturation mensuelle, résiliation à tout moment, et votre mémoire reste la vôtre en permanence.
Non. La mémoire de traduction renvoie les phrases que vous avez traduites et approuvées auparavant. La traduction automatique génère une nouvelle traduction à l’aide d’un moteur d’IA. WordBeam vous offre les deux : la mémoire renseigne d’abord chaque correspondance, et les moteurs d’IA ne traitent que ce qui est réellement nouveau.
Cela dépend entièrement du degré de répétition de votre contenu. La documentation récurrente, les contrats, les catalogues produits et les chaînes d’interface utilisateur se répètent fortement et peuvent réduire les coûts de retraduction jusqu’à 60 %. Un texte littéraire ponctuel peut n’apporter presque aucune économie. WordBeam analyse chaque fichier avant que vous ne commenciez afin que vous connaissiez à l’avance la répartition.
Oui. La mémoire est partagée entre vos projets, de sorte qu’une phrase que vous avez traduite pour un client est disponible lorsqu’elle réapparaît ailleurs, ce qui est la source des économies cumulées. La terminologie reste spécifique à chaque client via la base terminologique.
À vous. WordBeam est certifié SOC 2 Type II et conforme au RGPD avec résidence des données dans l’UE par défaut, et nous n’entraînons jamais de modèles publics sur votre contenu.
La mémoire de traduction est incluse dans chaque offre WordBeam : il n’y a aucun module TM séparé ni module complémentaire. L’offre Freelancer est à 30 $/mois jusqu’à 100 000 mots, Studio est à 80 $/mois jusqu’à 250 000 mots et jusqu’à sept utilisateurs, et des tarifs personnalisés en fonction du volume sont disponibles.
Oui, et vous devriez. La mémoire fonctionne au niveau de la phrase, la base terminologique au niveau du mot. Ensemble, elles maintiennent à la fois la formulation et la terminologie cohérentes, et les contrôles QA signalent lorsqu’un segment s’écarte de l’une ou de l’autre.
Traduisez plus vite, gardez davantage de chaque mot